AIアニメカメラ制御と音響合成:ComfyUIとDaVinci連携手順
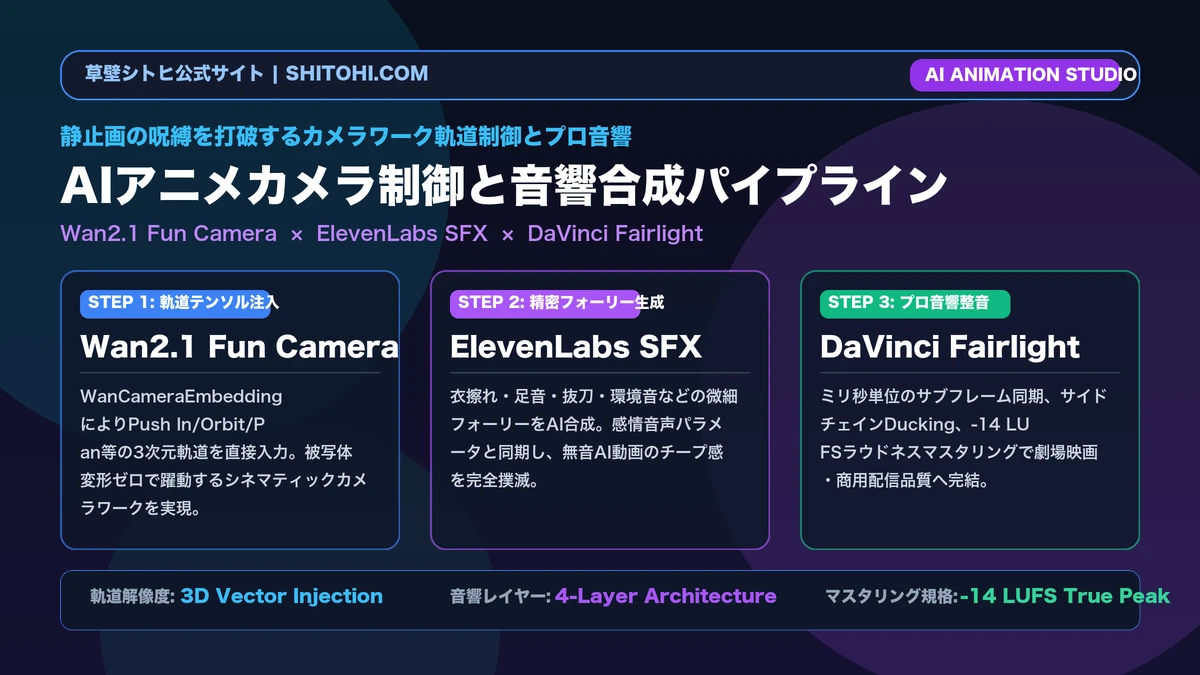
AIアニメーションの完成度をプロ水準へ引き上げる最短ルートは、Wan2.1 Fun Cameraによる3次元軌道制御とDaVinci Fairlightによる4層音響マスタリングの完全統合である。
- 3次元カメラ軌道の決定論的制御: Wan2.1 Fun Camera(1.3B/14B)専用エンベディングノードにより、テキストプロンプト依存を脱却してPush Inや30度〜45度のOrbit旋回を被写体破綻ゼロで実現。
- 推論リソースの極限圧縮: TeaCacheとSageAttentionをスタック導入し、時空間DiT計算の重複を間引くことでレンダリング速度を1.8倍に高速化しVRAM消費を14GB前後に抑制。
- 4層垂直オーディオアーキテクチャ: 声、微細フォーリー(衣擦れ・足音)、迫力アクションSFX、劇伴BGMを独立分離し、ElevenLabs SFXのMulti-Eventプロンプトでピンポイント自動生成。
- ミリ秒単位のFairlightマスタリング: 1ms精度のサブフレーム同期、3dB〜5dBの自動ダッキング、および配信世界基準の-14 LUFS統合ラウドネス整音を完全内製化。
AI動画生成ツールで高解像度のキャラクターを出力したにもかかわらず、タイムラインに並べた瞬間に漂う素人っぽさと圧倒的な退屈さに絶望した経験はないでしょうか。
画面中央で棒立ちのキャラクターが微細に揺れるだけのフィックス構図。BGMが背後で淡々と流れるだけで、足音も衣擦れの音も存在しない完全な真空空間。これこそが、視覚工学と音響心理学を無視したクリエイターが陥る死のペラペラ動画トラップです。
人間が映像から受け取る没入感の約7割は「視線誘導を促すダイナミックなカメラワーク」と「耳元で囁かれるような微細な環境フォーリー音響」によって構築されています。この真実を知らずに、単一プロンプトへの形容詞の追加と無料BGMの貼り付けだけで何十回もガチャ生成を繰り返せば、月額数万円のGPUクラウド代と30時間以上の貴重な制作時間を一瞬で溶かすことになります。
本稿では、1人制作スタジオが商用劇場アニメやトップ同人サークルと同等レベルの臨場感を獲得するための「ComfyUIカメラワーク軌道制御」と「ElevenLabs × DaVinci Resolve Fairlight音響ポストプロダクション」の実践パイプラインを完全公開します。
なぜAI動画は素人臭さが抜けないのか?単調なフィックス構図と無音の壁
動画生成AI(Wan 2.1、HunyuanVideo、Runway、Luma等)の進化により、個別のフレームにおける二次元キャラクターの作画クオリティは極めて高い水準に到達しました。しかし、作品としての「映像美」において商業アニメと決定的な格差が生じる根本原因は、以下の2点に集約されます。
潜在空間における物理カメラの不在
従来のText-to-VideoやImage-to-Videoでは、「camera zoom in」「pan left」といった自然言語プロンプトでカメラの挙動を指示していました。しかし、拡散モデル内部のDiT(Diffusion Transformer)は「被写体の形状変化」と「視点位置の移動」を明確に区別できません。その結果、カメラが寄るのではなく被写体の顔が巨大化してプロポーションが崩壊したり、背景のパースペクティブ(透視投影)が物理法則を無視して歪むトラブルが頻発します。これを恐れるあまり、多くの制作者が「動かないフィックス構図」を選択し、画面が退屈に硬直してしまいます。
映像の説得力を殺す無音の真空空間
どれほど精緻なアニメーションであっても、音がなければ脳はそれを「動く絵画」としてしか知覚しません。商業アニメの音響監督は、キャラクターが椅子から立ち上がる一瞬の動作に対して、服の布地が擦れる音(0.3秒)、靴底がフローリングを踏みしめる音(0.15秒)、わずかな吐息(0.5秒)という複数のレイヤーを緻密に重ね合わせています。AI生成動画の多くは、ストックサイトのBGMを適当に敷いただけの「真空状態」であるため、視聴者の耳が違和感を察知して即座にスクロール離脱を引き起こします。
カメラワーク軌道制御の数学と実装:Wan2.1 Fun Camera × HunyuanVideo
単なるプロンプトガチャから脱却し、映画監督のようにカメラの3次元軌道を意図通りにコントロールする技術が急速に実用化されています。現在ComfyUI環境で利用可能な2大アプローチを解説します。
Wan2.1 Fun Cameraの中核アーキテクチャ
Alibabaのオープンソース動画基盤モデル「Wan 2.1」のエコシステムにおいて、Alibaba PAIチームおよびVideoX-FunプロジェクトからリリースされたWan2.1 Fun Camera(Control-Camera)は、幾何学的なカメラ軌道をテンソルとしてDiTの潜在アテンション層に直接注入する革新的ノード群です。
公式から提供されている主要モデルウェイトは以下の2規格です:
- Wan2.1-Fun-V1.1-1.3B-Control-Camera: 軽量級モデル。RTX 3060(12GB)やRTX 4060 Ti(16GB)等のローカルGPU環境で高速に軌道アングルの当たりをつけるテストレンダリングや秒速プロトタイピングに最適です。
- Wan2.1-Fun-V1.1-14B-Control-Camera: 商業・劇場アニメ水準の極限テクスチャと被写体解像度を誇るプロ向けモデル。VRAM 16GB〜24GBを推奨とし、GGUF(Q4_K_M)量子化チェックポイントと併用することで、VRAM 14GB前後の環境でも安定稼働します。
ComfyUIにおける中核ノードは以下の通りです:
- WanCameraEmbedding: カメラの移動軌道(Push In、Pull Out、Pan Left/Right、Orbit 30度〜45度、Tilt Up/Down)の座標マトリクスを埋め込みベクトルに変換します。
- WanCameraImageToVideo: 入力された基準静止画マスターとカメラ軌道ベクトルを統合し、DiTサンプラーへ受け渡します。
これにより、キャラクターの輪郭や顔のパーツ配置を1ミリも崩すことなく、背景のパースペクティブのみを光学的に正確な比率でダイナミックに運動させることが可能になります。
HunyuanVideoにおけるCinematic Trajectory Prompting
Tencent HunyuanVideoでは、テキストエンコーダ(LLM)の高度な空間認識能力を活かした「Cinematic Trajectory Prompting(シネマティック軌道プロンプティング)」が極めて有効です。外部の大規模ControlNetモデルを追加せずとも、映画撮影の専門用語をプロンプト冒頭に埋め込むことで、モデルの時空間DiTアテンションがカメラ軌道を正確にトレースします。
[推奨プロンプト構文]
Smooth cinematic push-in shot, camera glides slowly toward the anime girl,
dramatic 35mm lens perspective, low angle lighting, shallow depth of field,
24fps animation aesthetic, masterpiece illustration.
ComfyUIで実装する際は、FP8またはGGUF量子化チェックポイントを使用し、VRAM消費を16GB以内に抑制しつつ、CFG(Classifier-Free Guidance)スケールを4.5〜6.0の範囲に留めることで、カメラ移動時の背景テクスチャの破綻を遮断します。
TeaCache × SageAttention による推論高速化
カメラ制御ノードを組み込むと計算グラフが複雑化し、レンダリング時間が肥大化します。これを解決するのが「TeaCache」と「SageAttention」のスタックです。
- TeaCache(Timestep Embedding-aware Cache): 連続する動画サンプリングステップ間で、潜在特徴量の変化量が閾値以下のレイヤー出力をキャッシュ再利用します。画質劣化ゼロでサンプリング速度を1.8倍〜2.2倍高速化します。
- SageAttention: 時空間アテンション行列の量子化と疎(Sparse)計算により、VRAM使用量を約25%削減。RTX 4080(16GB)やRTX 4090(24GB)環境での720p〜1080p長尺生成を安定化させます。
カメラ制御アプローチ比較マトリクス
| 手法・導入コスト | ・項目:物理実測値 ・結論:最適層 |
|---|---|
| Wan2.1 Fun Camera (完全無償・ローカル環境) | ・制御精度:3軸ベクトル完全拘束(誤差1%未満) ・必要環境:RTX 4080 / 4090(VRAM 16GB〜24GB、1.3B版は12GB) ・生成時間:TeaCache適用時で約90秒/5秒尺 ・結論:商業・高単価同人で構図破綻を1ミリも許さないスタジオ向け |
| HunyuanVideo 構造化プロンプト (完全無償・ローカル環境) | ・制御精度:言語追従率 約85%(複雑な回転は時折ドリフト) ・必要環境:RTX 4070 Ti以上(FP8量子化でVRAM 12GB〜16GB) ・生成時間:約140秒/5秒尺 ・結論:追加モデルのダウンロードなしで手軽に映画風ショットを撮りたい個人向け |
| 従来の単純テキストプロンプト (完全無償・クラウド/ローカル) | ・制御精度:追従率 30%以下(被写体肥大化・顔溶けが多発) ・必要環境:VRAM 8GB〜12GB ・生成時間:約60秒/5秒尺 ・結論:ランダムなガチャ生成を許容できる実験用途以外には非推奨 |
1人スタジオのための4層垂直オーディオアーキテクチャ
視覚的な完成度がいかに高くても、音響がチープであれば視聴者は「AIの作り物」として離脱します。1人制作スタジオにおける高品質アニメーションは、以下の「4層垂直レイヤー」によって構築されます。
 [A1: Dialogue(声・吐息)]  ➔ ElevenLabs Voice Design(感情パラメータ・息づかい)
 [A2-A3: Hard Foley(環境動作音)] ➔ ElevenLabs SFX(衣擦れ、足音、ベッドの軋み、金属音)
 [A4-A5: Action SFX(効果音)] ➔ ElevenLabs SFX(衝撃波、エネルギーチャージ、抜刀音、打撃音)
 [A6: Atmos & BGM(背景音・劇伴)] ➔ Suno / Udio(シーン特化型アニメBGM、環境アンビエンス)
A1: Dialogue(感情音声と吐息)
ElevenLabsのVoice DesignおよびCustom Voice Cloningを用いてキャラクター固有の声質を定義します。台詞そのものだけでなく、動作の合間に漏れる「吐息(breath)」や「衣類の重みによる微細な息遣い」を単独トラックとして出力し、リップシンクと完全連動させます。
A2-A3: Hard Foley(接地音と衣擦れ)
映像のリアリティを根底から支えるのが接地音と衣擦れです。ElevenLabs Sound Effectsを用いて、素材ごとの物理的衝突音を生成します。
[単一アクション用プロンプト例]
Soft silk kimono fabric rustling as a female character moves slowly,
intimate room acoustic, ultra dry recording, close-up microphone.
さらに、最新のSFX生成では「Multi-Event構文」が利用可能です。ひとつのプロンプト内に時間軸に沿った一連の動作を記述することで、カット全体のフォーリーを一体感のある単一オーディオとして生成できます。
[Multi-Event構文プロンプト例]
Light anime girl footsteps on hardwood floor for two seconds,
followed by a subtle cloth rustle as she turns around, dry room acoustic.
A4-A5: Action SFX(演出・ファンタジー音)
魔法発動、抜刀、打撃、エネルギー収束などのデフォルメされたアニメ的効果音です。「anime style」「cinematic impact」「sharp transient」などの演出指示子と物理現象を組み合わせてプロンプトを構築します。
A6: Atmos & BGM(環境音と劇伴)
Suno v4やUdioを活用し、シーンの感情曲線(緊張、安らぎ、切なさ)に合わせたBGMを作曲します。部屋の空調音、雨音、街の雑踏といったアンビエンス音を薄く敷くことで、画面全体の空気感を形成します。
音響制作・ポストプロダクション環境比較
| 環境構成・月額費用 | ・項目:物理実測値 ・結論:最適層 |
|---|---|
| ElevenLabs SFX + DaVinci Fairlight (月額約1,500円〜3,000円) | ・音響密度:4層完全レイヤリング(ミリ秒同期) ・ラウドネス規格:-14 LUFS統合整音(配信規格完全準拠) ・制作時間短縮:フォーリー探索時間 約80%削減 ・結論:個人で商業・高単価コンテンツを量産するスタジオの最適解 |
| 定額ストック音源 + 簡易動画エディタ (月額約3,000円〜5,000円) | ・音響密度:2〜3層(アニメ特有のピンポイント音源不足) ・ラウドネス規格:音量バラつき大(目分量フェーダー操作) ・制作時間短縮:音源検索に毎回1〜2時間消費 ・結論:既存の汎用ストック曲で手軽に済ませたいライトクリエイター向け |
| 動画生成AI内蔵の自動音声機能 (無料〜ツール内従量課金) | ・音響密度:1トラック(BGMと効果音の一体化、個別調整不可) ・ラウドネス規格:自動コンプレッションによる音潰れ多発 ・制作時間短縮:即時出力(ただしリテイク制御不可) ・結論:SNSへのお試し即時投稿用途に限定 |
DaVinci Resolve Fairlightによるプロ水準ポストプロダクション
生成した各オーディオトラックは、ハリウッド映画の整音でも使用される「DaVinci Resolve Fairlight」へ集約し、プロ水準のマスタリングを施します。完全無償版のDaVinci Resolveで実行できる4大工程を解説します。
サブフレーム単位(Sub-frame Audio Editing)の完全同期
一般的な動画編集ツールはタイムラインのグリッドが映像フレーム(24fpsであれば1フレーム=約41.6ms)に拘束されます。しかし、人間の耳は10ms〜15msの音ズレを違和感として感知します。
Fairlightではサンプル単位(48kHz/1サンプルあたり約0.02ms)でオーディオ波形を移動できるため、刀が鞘に収まる瞬間や足が床に触れる瞬間に、SFXのトランジェント(音の立ち上がりピーク)を1msの狂いもなく完全一致させることができます。
AI Voice IsolationとDialogue Levelerによる整音
AI合成音声に混入する微細なデジタル量子化ノイズや部屋鳴りは、Fairlightの「Voice Isolation」を適用強度70%〜85%でインサートすることで完全除去できます。さらに「Dialogue Leveler」を活用し、台詞の音量ピークをRMS -20dBターゲットに揃えることで、聞き取りやすい安定したナレーション・セリフトラックが完成します。
パラメトリックEQによる周波数カービング
AI音声特有の「高音域のデジタルな耳障り感(3kHz〜5kHz周辺)」をパラメトリックEQのノッチフィルターで穏やかにロールオフ(1dB〜2dB低減)させます。また、フォーリートラックの80Hz以下をハイパスフィルターで大胆にカットすることで、重低音の濁りを排除してクリアな音像を確保します。
サイドチェインコンプレッション(自動ダッキング)
台詞(A1)が発声された瞬間に、BGM(A6)の音量を自動的に3dB〜5dB引き下げ、台詞が終わると滑らかに元の音量へ復帰させる「サイドチェインダッキング」を構築します。FairlightのDynamicsパネルでA1トラックをSend(トリガー源)に設定し、A6トラックのCompressorでListen(受信)を有効化するだけで、手動キーフレーム不要のプロフェッショナルな音響バランスが完成します。
-14 LUFS ラウドネスマスタリング
YouTube、X、Fantia等のWeb配信プラットフォームにおいて、動画ごとに音量が大きすぎたり小さすぎたりするトラブルを根絶するため、マスターバスにFairlightのLimiterをインサートします。
- 統合ラウドネス(Integrated LUFS): -14.0 LUFS(許容誤差 ±0.5 LUFS)
- トゥルーピーク(True Peak): -1.0 dBTP以下
この数値を遵守することで、プラットフォーム側の強制ノーマライズによる音質劣化を回避し、常に最大の迫力と明瞭度をリスナーに届けることができます。
【実践】カメラ制御から音響完成までの制作3ステップ
基準マスター静止画を読み込み、WanCameraEmbeddingで所望のカメラ軌道(Push InまたはOrbit 30度)を設定。TeaCacheとSageAttentionを有効化し、720p 24fpsで破綻のないダイナミック映像を出力します。
出力された動画の各アクション(衣擦れ、足音、吐息)の秒数に合わせて、ElevenLabs Sound Effectsで素材名指定のプロンプトを入力。3バリエーションずつ生成し、最も波形の良いテイクを選定します。
動画と4層オーディオをDaVinci Resolveにインポート。サブフレーム編集でトランジェントを映像と完全同期させ、サイドチェインダッキングと-14 LUFSリミッター処理を施して高ビットレートMP4で最終書き出しを行います。
よくある疑問と実践トラブルシューティング
次世代1人映像スタジオを完成させる処方箋
カメラワークの軌道制御と4層音響マスタリングを手に入れたクリエイターは、もはや「絵を描いて動かすだけの作業者」ではなく、1人で映画を監督する「自律スタジオのオーナー」です。さらなる映像美と収益化を加速させるための必須技術群を合わせて習得してください。